设想一次律所的AI应用汇报:账号已经采购,培训已经举行,调用次数也在增加。会议结束前,还有一个问题需要回答:下一次工作交付,究竟改善在哪里?
负责管理的人可能没有看过完整的工作过程。账号记录证明工具被打开过,培训人数证明人参加过,调用次数证明系统收到过请求。要判断是否适合继续投入,还需要看到一项任务怎样准备、生成、核验,最后由谁接受。
我的建议是先做一张任务验收表。选一项范围清楚的工作,固定材料与交付标准,把人工准备、核验和返工都记下来,再看结果能否使用。暂时不用给全所算一个“AI效率提升率”。
一、企业在披露什么,和AI有没有用,是两件事
a16z于2026年9月30日发布的《State of Markets II》,第27页放了两组AI采用情况。右侧图中,标普500公司2026年第二季度的公开披露,74%涉及AI计划或目标,69%涉及已经部署且有使用或采用数据,29%涉及量化成果,2%涉及跨期跟踪的指标。市场报告原页
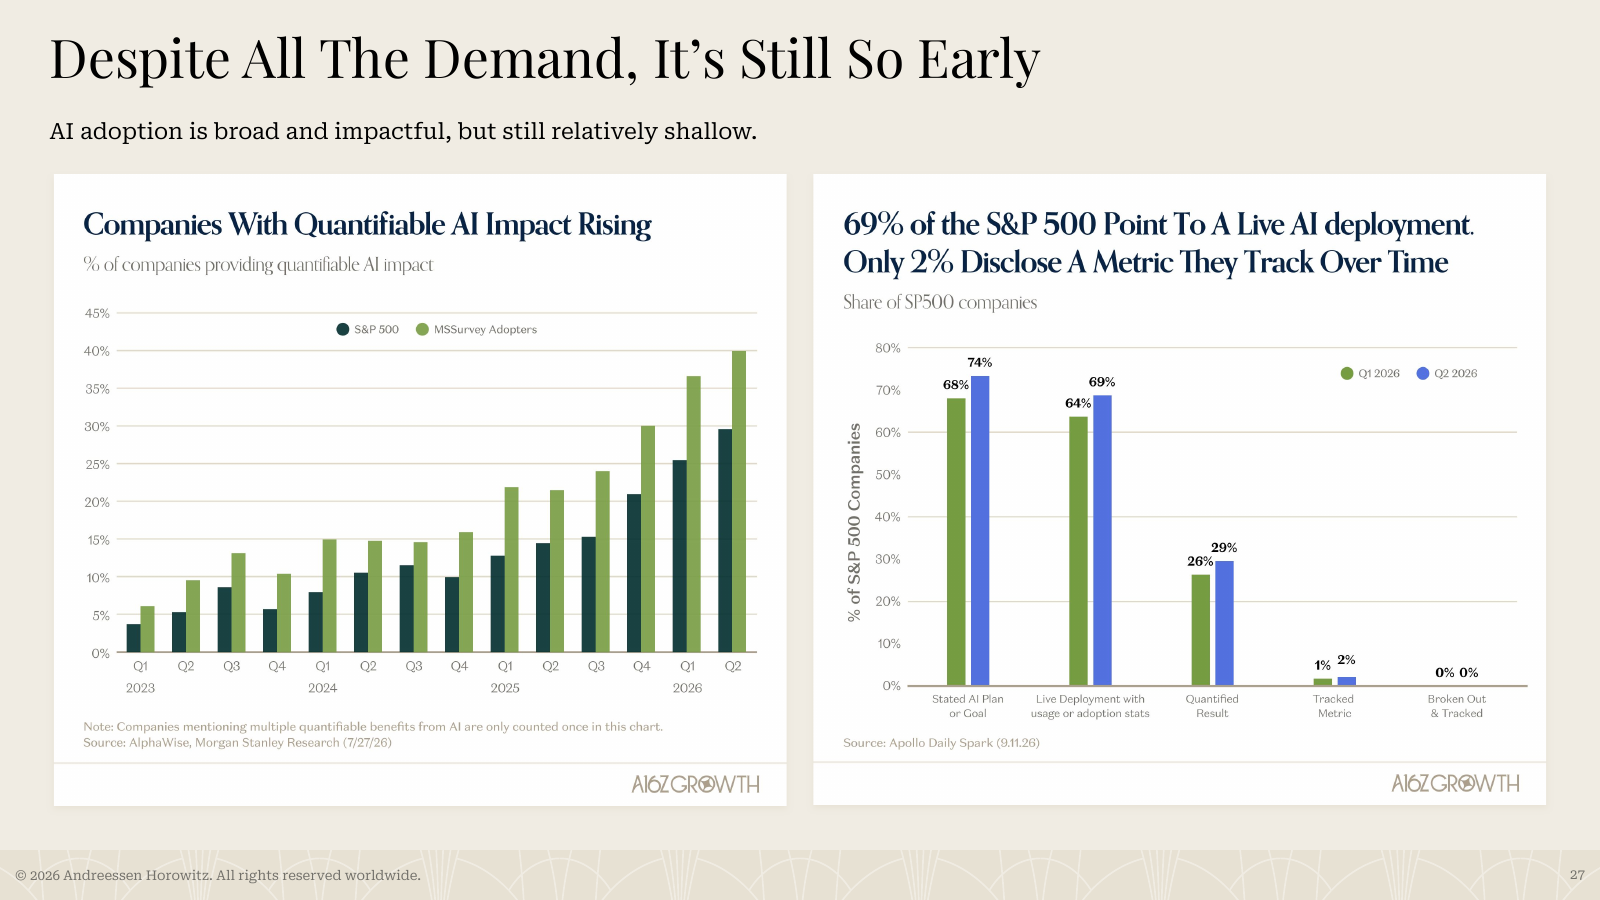
图源:a16z《State of Markets II》,第27页。本文解释右侧图,原标注来源为Apollo Daily Spark,2026年9月11日。左侧是AlphaWise/Morgan Stanley的另一组观察,样本与口径不同,不能合并成同一条趋势。原图可点开放大查看。
这组数最容易被改写成“只有2%的企业用AI有效”。这种说法跨过了数据的边界。图表观察的是公司向外披露了什么;没有披露跨期指标,不等于内部从未测量,更不等于没有成果或没有盈利。
这几个分类也不是一条互斥的漏斗,不能用29除以69,算出“部署成功率”。它们适合帮助管理者区分计划、采用、结果和持续跟踪,却不能替任何一家律所打分。
对律所的启发,是检查自己的应用汇报是否也停留在前两层。我们能否拿出一项可复查的交付,说明用了什么材料、经过怎样的核验,和原先的做法相比有什么变化?这要在自己的任务里找答案。
二、输出更多,也需要知道多出来的是什么
OpenAI在2026年8月12日发布的企业使用观察中,按每活跃用户的输出token衡量使用深度。到6月,使用强度居前10%的企业,为45—55分位企业的8.3倍。token可以粗略理解为模型处理和输出文本的计量单位。OpenAI原文
这是OpenAI企业客户样本中的使用差异,不能读成生产率相差8.3倍。多步骤任务会产生更多中间输出;反复尝试、纠错和重写,也会增加输出。最后可交付的成果,仍需单独检查。
因此,使用日志适合告诉我们哪些人和任务值得进一步了解。它可以帮助发现正在形成的工作习惯,也可以暴露大量反复修改的过程。管理者若把输出量直接设为绩效目标,反而可能鼓励把任务做长、把答案写多。
我更愿意先看一份短而可查的工作材料。它明确标出依据和缺口,让负责律师迅速定位需要判断的问题。一份很长的报告,如果事实来源散落、判断层次混在一起,复核成本可能更高。这是交付要求的差异,要靠任务记录验证。
三、先验收一个公开材料任务
初次试行可以选择一项公开资料整理。例如,根据几份公开行业报告,为内部学习准备一页事实清单,保留来源、统计期间和口径,再列出两项需要继续研究的问题。这里是方法演示,没有对应任何真实客户项目。
开始前,负责人要把范围写清:只采用哪几份材料,截止时间是什么,哪些信息不能推断,成果交给谁。验收标准也先写下来,例如数字能回到原页、作者观点不写成事实、缺失信息明确标注。
接下来记录全过程。准备材料与规则花了多久,生成需要多久,核验与返工又花了多久。若只记生成时间,就会把成本最重的一段藏掉。核验由较资深的人员承担时,还需要单独注意其时间,不能把不同人员的一小时视作完全相同的资源。
一张表可以这样设置:
| 记录项 | 具体留下什么 |
|---|---|
| 任务与版本 | 材料清单、日期、难度、工具/规则版本 |
| 验收要求 | 用途、格式、必须保留的来源、不可省略的问题 |
| 人工投入 | 准备、核验、返工时间;分别记录执行人与复核人 |
| 主要缺陷 | 数字错误、来源缺失、关键遗漏、越过材料作判断 |
| 最终结果 | 可用、修改后可用、弃用;附具体原因 |
| 后续复用 | 哪些材料或规则可再用,哪些依然需要重做 |
这张表是我提出的管理方法,不是a16z公布的律所测试结果。记录也无需追求表面精确:暂时无法合理估算的成本,可以先保留说明,胜过填入一个没有根据的数字。
要比较不同做法,就尽量让材料复杂度和交付目标接近。拿一个简单任务的AI耗时,去和另一个复杂任务的人工耗时比较,容易得到漂亮却没用的结论。工具和规则变化后,也要留下版本信息,否则后续的人无法解释为什么结果不同。
质量检查应保留不能用的成果。错误不应在汇报前被悄悄删掉,再把人工重做的结果全部算在AI名下。否则管理者只能看到修补后的成品,看不到是谁承担了修补工作。
同样,一个任务做得好,也不能立即推广到所有任务。材料类型、复杂程度和验收要求变了,原来的规则可能失效。先积累几次同类任务,观察反复出现的缺陷,通常比急着向全所宣布成效更稳妥。
四、伙伴需要上下文,也需要有人验收
我更倾向于用“伙伴+上下文、规则、验收”来管理模型。这个观点落到团队工作中,意味着至少要明确几项责任:谁给它材料,谁说明任务边界,谁维护可复用规则,谁判断结果能否进入下一步。
采购与账号管理仍有必要,但它们无法代替这些责任。通用OA可以确认一个流程节点有没有提交;模型还需要知道这次材料为什么重要、什么不能假设、成果应该允许谁检查。换一种任务,可能就要换一套上下文和规则。
培训也可以围绕同一张验收表组织。让参加者面对同一组公开材料,说明准备过程,互相检查出处和遗漏,再讨论哪条规则值得留下。培训结束后,团队拥有的就不只是课件,还有一项能够再次运行、接受批评的工作方法。
这里还要留出失败的出口。如果准备与复核成本一直很高,或者同类错误反复出现,可以缩小任务范围,也可以暂停使用。高风险工作本来就需要更严格的专业判断,不应为了证明采购正确,勉强把工具推到不适合的位置。
下一次汇报时,先选一份小而完整的任务记录:材料、规则、待审结果、缺陷、返工、最终决定。它未必能支持一个全所效率数字,却能帮助负责人作出下一步是否投入、怎样投入的具体判断。
资料说明: 采用a16z《State of Markets II》所附PDF第27页,以及OpenAI2026年8月12日企业使用观察。公开披露率与使用强度均不能直接衡量律所生产率。本文为工作方法建议,不涉及具体案件、法律规范结论或已实施项目的成效。
作者简介: 陈石律师(主页 chenshi.ai),浙江海泰律师事务所副主任、高级合伙人、房地产与建设工程部主任,第十届宁波市律师协会常务理事、第七届宁波仲裁委员会仲裁员,聚焦建筑房地产、投融资、并购重组及商事争议解决。曾获多家法律媒体与专业机构认可,荣登 LegalOne 2025 中国区建工及房地产实务先锋 45 强、律新社 2025 年度管理合伙人 20 佳(华东),入选《商法》The A-List 法律精英,获评 ALB China 区域市场十五佳长三角地区律师新星,并获律新社 2024 年度并购领域品牌之星。长期为万科、华润置地、信达地产、保利置业、招商蛇口、中海地产等企业提供法律服务,承办“首宗百亿地王”“长春第一高楼”“台州第一高楼”等代表性项目,累计服务项目投资额超千亿。近年来持续推动 AI 与法律实务融合,强调以结构化方法打通技术逻辑、法律判断与商业场景;著有《赋能法律人:AI 底层思维与应用范式》,并在多地开展相关主题讲座与分享。